
OCR 识文字
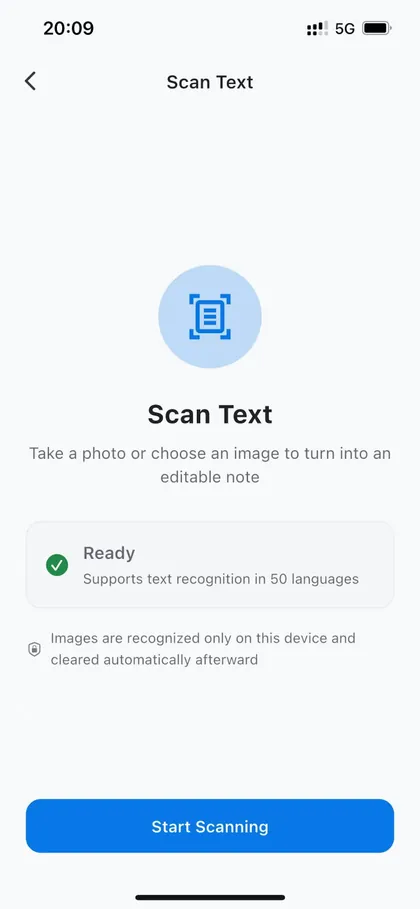
把图片里的文字,变成真正可以编辑和搜索的内容。
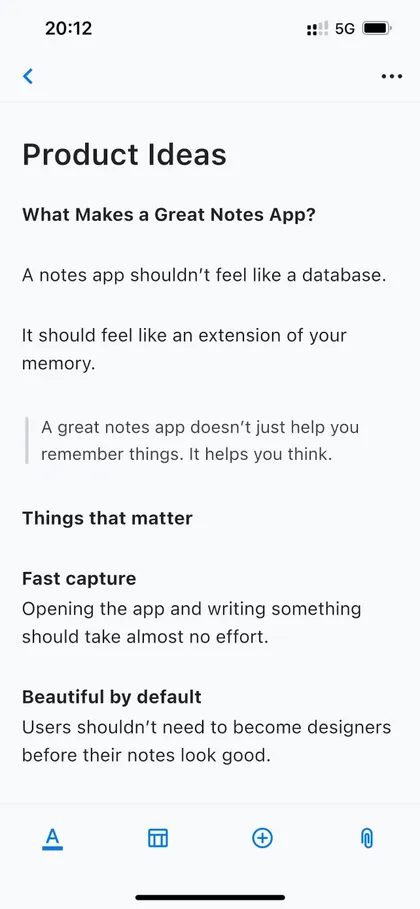
识别结果进入笔记后,就可以像其他知识一样编辑、搜索、与别的材料组合,也可以由你选择后交给 AI 处理。
使用流程
从原始信息到可以再利用的知识。
OCR 是信息进入 MemoFlow 知识空间的一种方式:图片会变成笔记中的可编辑文字,而不是只留下一张无法整理的扫描图。
01
拍摄书页,或从相册选择图片
02
识别:普通模式在设备上完成,复杂版面可选高级模式在云端识别
03
校对并整理可编辑结果
04
搜索内容,或把这条笔记交给 MemoFlow AI 继续处理
相机或相册导入
从相机或已有图片开始识别。
普通端侧识别或高级云端识别
普通识别在支持的设备上完成;高级识别会把图片上传到云端,首次使用前需要你确认。
识别结果可继续编辑
识别后仍然可以修改和格式化。
使用说明:清晰、正向且光线充足的印刷文字通常效果更好。高级识别旨在把标题、列表和表格保留为可编辑内容块,但效果因文档而异,仍需核对;手写体和证件不保证完整识别。
普通 OCR 在设备端识别印刷文字,但启动时需要联网完成 Credits 授权(Basic 每张图片 1 Credit,Plus 与 Pro 免费)。高级 OCR 会把图片上传到云端处理复杂版面,所有套餐每张图片 2 Credits。请核对和修正草稿后再保存为笔记。当前普通模式的 OCR 语言列表不包含韩语。
OCR 语言
识别 47 种语言的印刷文字
普通模式下,所有语言由同一个设备端模型识别,无需选择语言:拍下页面,识别结果会按原文所用的文字返回。高级(云端)识别是独立模式,其语言范围不在此列表中。
- 简体中文
- 繁体中文
- 日语
- 英语
- 法语
- 德语
- 意大利语
- 西班牙语
- 葡萄牙语
- 荷兰语
- 波兰语
- 罗马尼亚语
- 捷克语
- 斯洛伐克语
- 斯洛文尼亚语
- 克罗地亚语
- 波斯尼亚语
- 塞尔维亚语(拉丁文)
- 瑞典语
- 挪威语
- 丹麦语
- 芬兰语
- 冰岛语
- 爱沙尼亚语
- 拉脱维亚语
- 立陶宛语
- 匈牙利语
- 土耳其语
- 阿塞拜疆语
- 库尔德语
- 阿尔巴尼亚语
- 马耳他语
- 爱尔兰语
- 加泰罗尼亚语
- 巴斯克语
- 加利西亚语
- 奥克语
- 卢森堡语
- 罗曼什语
- 拉丁语
- 南非荷兰语
- 印度尼西亚语
- 马来语
- 菲律宾语
- 斯瓦希里语
- 毛利语
- 克丘亚语
普通模式不支持:韩文、西里尔文(如俄文)、阿拉伯文、希伯来文、泰文、印地文、希腊文和越南文。 印刷文字效果最好;手写、表格和复杂版式不保证识别效果。
同一个知识空间
这项能力之后连接到哪里。
识别结果进入笔记后,就可以像其他知识一样编辑、搜索、与别的材料组合,也可以由你选择后交给 AI 处理。
继续探索